
Предисловие
Написано уже немало статей о платформах разработки. Кажется, уже приблизились к устоявшемуся определению internal development platform, с которым согласно большинство.
Появились десятки материалов о platform engineering, happy-path-разработки, devex и о том, как лучше снизить когнитивную нагрузку на программистов. Мы же, в свою очередь, в рамках этой статьи зайдем с другой стороны и попробуем порассуждать о платформе с точки зрения зрелости разрабатываемых сервисов. Так, инструменты, которые идеально подходят на старте для двух фаундеров с гипотезой, могут стать тормозом для SaaS-продукта с сотнями клиентов, а полноценная IDP, оправданная для корпорации, может быть избыточной для команды из 20 разработчиков.
Эта статья для тех, кто со своим продуктом уже прошел стадию MVP и чувствует, что текущая инфраструктура начинает тормозить рост — по костам, архитектуре или требованиям первых крупных клиентов.
Мы планируем цикл публикаций о платформах разработки для команд, находящихся в переходной фазе. Это те, кто вырос из инструментов первых двух этапов, продолжают свой путь в облаке и движутся к полноценной IDP. Начнем с разбора того, какие стадии развития решения можно выделить, что соответствует тому или иному этапу, какие инструменты обычно используются на каждом шаге.
Уходя немного в сторону, заметим, что большинство статей о платформах рассматривают их как универсальное благо. Но, на наш взгляд, разные инструменты для разработки подходят каждый для своего этапа — и от этого они не становятся лучше или хуже друг друга. Это решения, у которых есть определённый уровень зрелости. Если он не совпадает с уровнем зрелости платформы, то она будет только тормозить развитие или даже мешать ему.
В основе наших рассуждений лежит простая идея: платформа разработки должна соответствовать уровню зрелости разрабатываемого решения. Под этим мы будем понимать:
- требования к управляемости;
- требования к безопасности;
- предсказуемость экономики.
Мы попробуем разобрать все стадии на примере одного продукта — SaaS для автоматизации документооборота. Цель данного продукта — помочь бизнесу автоматически разбирать входящие договоры, извлекать ключевые условия и формулировать задачи юристам.
Флоу работы сервиса простой:
- загрузка PDF-документа;
- извлечение данных;
- уведомление в мессенджере;
- дальнейшая работа с документами в панели управления.
Это синтетический пример, на котором мы проследим путь от быстрого прототипа до enterprise. Нами был выбран сервис документооборота, потому что его развитие — это хороший стресс-тест для архитектуры и инфраструктуры. Он сочетает синхронные запросы пользователей, тяжёлые асинхронные задачи (LLM-обработку документов), должен соответствовать требованиям по изоляции данных и неизбежно — требованиям enterprise-клиентов по безопасности и контролю.
Этап 1. Проверка гипотезы
Начнем мы с самого первого этапа (которым, кстати, многие пренебрегают) — с проверки гипотезы. На этой стадии есть только идея, которая может материализоваться в некий прототип, способный ответить на вопрос, а нужно ли это вообще кому-то, или кануть в лету. Как правило, реализовать это необходимо максимально быстро (и лишь по возможности максимально качественно).
В эпоху повсеместного внедрения ИИ с этим прекрасно справляются такие сервисы, как Replit, Lovable и другие аналоги. Отчасти сюда можно добавить Tilda и Wix. Предположим, что выбран Replit.
Механика работы простая:
- Описываем, как должен выглядеть и функционировать продукт. Это может быть лендинг, бот, приложение текстом. Само описание, кстати, также можно сгенерировать с помощью того же ИИ.
- Получаем вариант реализации.
- Дорабатываем.
- Автоматически создается и настраивается хостинг и простая БД, которую предоставляет платформа.
- В один клик деплоим на предоставляемый платформой хостинг.
Минимальный вход, минимальные знания в разработке (это не претензия к людям, которые пользуются этими сервисами — просто факт), максимальная скорость выхода. Фактически получается черновик будущего приложения.
На этом этапе платформа — это не инструмент для создания полноценных сервисов, а ускоритель проверки гипотез. И это нормально — на данном этапе большего и не нужно. Нужно проверять спрос, а не строить инфраструктуру.
Для многих этого вполне достаточно. Некоторые используют такие сервисы для полноценной работы своих продуктов, на которые заходят пользователи и платят деньги. В качестве успешного примера можно рассмотреть Питера Левелса с его продуктами, разработанными практически только с помощью no-code-инструментов. Среди его продуктов — Photo AI (сервис с самой большой монетизацией) и Nomad List (сервис с самым большим количеством посещений).
На начальном этапе архитектура максимально простая:
- одна база данных;
- одна схема;
- все клиенты внутри одного тенанта;
- интеграция с внешней LLM;
- авторизация через встроенные механизмы используемого для разработки решения.
На старте выбираем Replit и за пару дней запускаем прототип. Через месяц у нас:
- почти нулевая операционная сложность;
- 600 посетителей в месяц;
- 50 регистраций;
- 10 активных клиентов;
- MRR (monthly recurring revenue) — 500 $;
- 250 документов в месяц.
Нагрузка:
- 1–3 документа в час;
- пиковая нагрузка — до 5 документов в минуту (при демо, рассылке).
Косты — 50 $ в месяц на фиксированном тарифе по подписке. В эту стоимость входит:
- лимит на CPU и RAM на проект;
- ограниченный объем хранилища;
- хостинг внутри инфраструктуры платформы;
- базовые возможности деплоя.
Отдельных тарифов на трафик или выполнение функций нет — ресурсы ограничены рамками выбранного тарифа. Инфраструктура также не зависит от трафика — она встроена в абстракцию платформы.
Ух, 10 платящих пользователей, ежемесячный доход 500 $ — кажется, гипотеза выстрелила.
Этап 2. Рост
Сервис не стоит на месте и развивается дальше. Запустили маркетинг и через 2 месяца получили:
- 10000 посетителей в месяц;
- 500 регистраций;
- 80 активных клиентов;
- MRR — 2000 $.
Кажется, неплохо. При этом нагрузка растёт, мы уже обрабатываем 6 000 документов в месяц, и сервис начинает подвисать. Всё-таки Replit — это шаренная инфраструктура с ограниченными CPU и RAM. При росте объема трафика пользователи упираются в лимиты контейнера: начинается throttling (ограничение процессора), задержки в ответах или перезапуск процесса из-за нехватки памяти. Обработка документов в пике занимает минуты. Горизонтальное масштабирование либо отсутствует, либо скрыто и не управляется пользователем. Если одновременно приходит много запросов, очередь растёт, event loop в Node.js блокируется долгими синхронными операциями (например, парсингом PDF), что ведёт к лагам и тайм-аутам во всех запросах. Нет автоматического добавления реплик под нагрузкой.
- инфраструктура полностью абстрагирована (помним, что приложение развертывается и хостится в подготовленной платформой инфраструктуре);
- доступ к настройкам сетей и безопасности (anti-DDoS, WAF) ограничен;
- нет изоляции данных клиентов;
- контроль над окружениями минимальный;
- командная разработка ограничена.
В этот момент команда понимает, что уже нельзя относиться к продукту как к прототипу. Нужен полноценный prod-ready с возможностью дальнейшего масштабирования.
Это первый инфраструктурный перелом.
Плюс команда растет — уже есть возможность подключить к проекту нескольких разработчиков, которые будут работать в Git. Но пока без DevOps-команды (дорого или не хватает компетенций).
На этом этапе уже сильно ощущается отсутствие:
- контроля ресурсов;
- возможности настроить масштабирование;
- отдельной тестовой среды.
Здесь на сцену выходят managed-runtime-платформы вроде Vercel, Heroku, Fly.io, Deno Deploy, а также российские решения, такие как Dockhost и Amvera.
Принцип работы этих решений:
- К платформе подключается Git (например, GitHub).
- Код продукта хранится в GitHub.
- При отправке изменений запускается автоматическая сборка.
- Платформа деплоит автоматически.
- Используется автоматическая сборка и упаковка приложения в изолированную среду выполнения. Как правило, для этого применяются buildpacks (Cloud Native Buildpacks), которые:
- определяют стек;
- собирают контейнер;
- формируют OCI Image.
Что появляется:
- автоматическое масштабирование;
- автоматический выпуск новых версий;
- отдельные тестовые окружения для каждой ветки;
- базовая защита от DDoS-атак на уровне облачного провайдера;
- возможность настроить web application firewall (если доступен);
- встроенные механизмы TLS;
- инженер по инфраструктуре (пускай даже пока его участие минимально).
И кажется, эти сервисы выглядят как серебряные пули. Возможно, так и есть — давайте разбираться. Для этого вернемся к нашему примеру.
На этапе MVP у нас был простой сервис для загрузки PDF, извлечения данных. Теперь появляются первые реальные сценарии использования и запросы от пользователей. Клиенты начинают работать с сервисом ежедневно. Появляются разные типы документов. Возникает потребность получать уведомления разными способами (по СМС, почте, в мессенджере), просматривать историю изменений, а также важно, чтобы была доступна повторная обработка документов (например, при изменении логики извлечения данных или исправлении ошибок распознавания). Добавляется хранение истории документов. Появляется статусная модель обработки (received, parsed, validated, completed). Внедряются базовые роли (владелец аккаунта, сотрудник). Появляется примитивное разделение данных по организациям (multi-tenant-логика на уровне приложения). Добавляется логирование действий пользователей. Новые возможности увеличивают MRR и привлекают новых пользователей.
Отдельно отметим первый самый простой подход к multi-tenancy — добавить поле organization_id в каждую таблицу и фильтровать данные на уровне приложения. Это сработает на этом этапе, но закладывает архитектурный долг: один баг в WHERE-условии — и клиент А видит данные клиента Б. На следующем этапе, когда появляются корпоративные клиенты с требованиями по изоляции, этот долг придётся погашать — либо через PostgreSQL Row Level Security, либо через schema-per-tenant, либо через полную физическую изоляцию.
Что касается затрат: использование Vercel обойдется в среднем порядка 400 $ в месяц.
Этап 3. Зрелость и контроль
Проходит еще полгода, и теперь у нас:
- 35 000 посетителей в месяц;
- 1500 регистраций;
- 150 активных клиентов (часть — корпоративные);
- MRR — 6 000$.
И вот тут могут начать происходить странные вещи: косты могут составлять порядка 2500 $ в месяц. Модель тарификации включает фиксированную подписку и доплату за использование (usage-based). Итоговая сумма зависит:
от объема документов;
среднего времени выполнения функций;
объема используемой памяти;
количества деплоев и preview-сред;
объема CDN-трафика;
числа участников команды.
В отличие от 1-го этапа, расходы начинают масштабироваться вместе с нагрузкой.
И вот тут заключается одна из основных сложностей работы с Vercel. Проблема не в размере счета, а в его непредсказуемости — рост количества посещений сайта на 40% может увеличить счет на 70–90%, так как оплата идет за время выполнения, используемые объемы памяти и сетевого трафика, дополнительные окружения и абстракции типа виртуальных процессов выполнения. Например, dyno в Heroku и serverless runtime в Vercel,о которых мы поговорим в следующей статье. Спойлер: там в целом попробуем разобраться, что это и зачем они были введены. Да, такая вот цена за DevEx и счастье разработчика.
Счета могут составлять 40% MRR. Главное, что косты на масштабе плохо прогнозируемы, что рушит всю unit-экономику продукта.
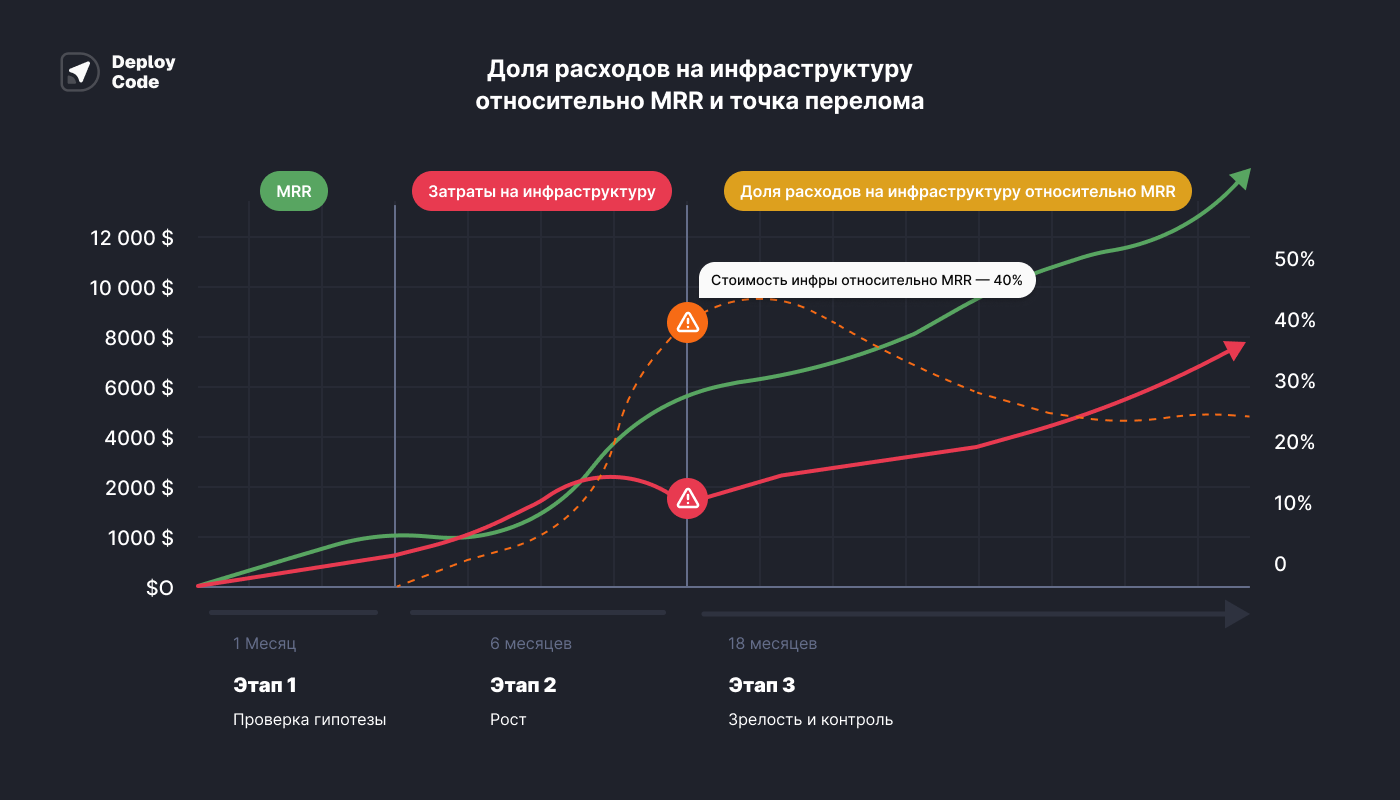
Вторая точка перелома: когда инфраструктура начинает съедать прибыль
На ранних стадиях выручка существенно опережает инфраструктурные затраты, и о соответствии требованиям или контроле процессов никто всерьез не задумывается. Но по мере масштабирования, оказавшись в определенной точке, компания сталкивается не столько с денежными проблемами, сколько с проблемой управляемости инфраструктуры.
И дело не в том, что Vercel или Heroku плохие, а в том, что они решают задачу быстро и предсказуемо деплоить, но не задачу контролировать инфраструктуру. И это их сознательный подход к построению своих платформ: вы получаете простоту в обмен на контроль. Платформа не решает задачи сложной сетевой топологии или кастомной безопасности на уровне инфраструктуры, а заточена на создание двенадцатифакторных приложений (кстати, термин популяризирован как раз Heroku).
И да, наше приложение не стоит нам месте - это уже больше, чем SaaS для документооборота: появляются партнеры, которые интегрируют свои решения. К этому моменту продукт уже не просто сервис обработки PDF — добавились:
- публичное API;
- кастомные роли и разграничение прав;
- поддержка multi-tenant-архитектуры с изоляцией данных;
- поддержка гибридных и on-prem-сценариев развертывания;
- партнёрская модель интеграций.
И да, вы заметили, что на этом этапе появляются первые крупные корпоративные клиенты? И вот они будут приходить со следующими вопросами:
- Можно ли развернуть сервис в отдельной виртуальной сети?
- Можно ли ограничить доступ по IP?
- Можно ли подключить собственный web application firewall?
- Какой SLA? Как вы следите за его исполнением?
Ответить прямо на эти вопросы не получится, так как в таком случае клиенты услышат что-то вроде: «Ничего из этого на текущий момент нереализуемо, потому что есть ограничения платформы, на которой мы разрабатываем». И тут команда впервые чувствует отсутствие контроля над инфраструктурой. В этот момент срабатывает триггер и команда понимает, что отвечает перед клиентом, но не контролирует среду.
Чтобы понять, почему так произошло, сделаем шаг назад. Исторически Vercel и Heroku обеспечивают деплой приложений в AWS, используя для этого собственные уровни абстракции (serverless model и dyno). В связи с этим:
- не предусмотрено полного контроля над сетевой топологией (у Vercel есть enterprise-опции,
приватные подключения и VPC-коннекторы через AWS, но это не дает всей полноты возможностей):
- нельзя кастомно настроить виртуальные сети;
- нет возможности применить собственные правила маршрутизации;
- отсутствует изоляция клиентов на уровне сети.
- нет настраиваемого IAM;
- ограниченная observability;
- не предусмотрена интеграция со сторонними системами безопасности;
- отсутствует контроль расположения инфраструктуры.
Значит пришла пора оставить PaaS позади: счета стали непредсказуемыми, корпоративные клиенты требуют изоляции, архитектура продукта переросла абстракции Vercel и Heroku. Логичный следующий шаг — облачная инфраструктура (managed K8s, VM, VPC, собственные сети). VK Cloud, Yandex Cloud, Selectel и другие облачные провайдеры открывают возможность иметь полный контроль над инфраструктурой.
Сложность миграции из Vercel опишем в следующей статье.
И вот наконец мы в облаках. Переход дает то, чего не могли дать ни Replit, ни Vercel, — реальный контроль над инфраструктурой. И это меняет экономику, возможности и разговор с клиентами.
Стабилизиоуется выручка. При грамотной конфигурации доля расходов на инфраструктуру относительно MRR снижается до 25% — оплата только за потребленные ресурсы, а не за абстракцию платформы с её наценкой за удобство. Managed K8s позволяет гибко управлять ресурсами: использовать автомасштабирование в зависимости от реальной нагрузки, spot-инстансы для фоновых задач, раздельные пулы узлов для разных типов рабочих нагрузок.
Появляется возможность выполнять требования клиентов и регуляторов. Хостинг в российских дата-центрах (Yandex Cloud, Selectel, VK Cloud и т. д.) закрывает требования закона № 152-ФЗ о локализации персональных данных — вопрос, который раньше было невозможно даже обсуждать с корпоративными клиентами. Теперь можно честно ответить на вопросы о VPC, изоляции сетей, журналах доступа, расположении данных. Появляется возможность подписывать enterprise-контракты с требованиями к инфраструктуре.
Гибкость настройки становится реальной. Собственные правила маршрутизации, кастомные security groups, network policies на уровне кластера, интеграция с корпоративными IdP через OIDC — всё это теперь доступно и настраивается под конкретные требования, а не определяется платформой.
Этап 4. Унификация процессов
Немногие компании оказываются на этом этапе — просто не дорастают до момента, когда приходит необходимость стандартизировать процессы в том числе и разработку и как следствие необходимость использования IDP. Тем не менее важно его обозначить , чтобы картина была полной. IDP оправдана, когда есть:
- более 50 разработчиков;
- выделенная платформенная команда (примерно 5 человек);
- готовность бизнеса инвестировать 6–12 месяцев в построение внутреннего продукта.
Инструменты этого уровня — Backstage (портал разработчика от Spotify), Humanitec, Qover и другие. Отечественные — VK Dev Platform, Platform V, «Сфера», «Марлин». А также внутренние платформы, которые крупные компании создают под свои потребности. По нашим наблюдениям, большинство компаний на этом этапе всё-таки строят платформу под себя, а не покупают готовое решение — слишком специфичны внутренние процессы и требования.
Ключевое отличие от предыдущих этапов заключается в том, платформа здесь — это отдельный продукт со своей командой, дорожной картой и внутренними пользователями в лице разработчиков. Golden paths, стандартизированные окружения, self-service для команд — всё это появляется именно здесь.
Для команды из 20–30 разработчиков это преждевременная оптимизация. Стоимость построения и поддержки IDP будет выше, чем боль от её отсутствия.
Разрыв
Давайте зафиксируем момент, в котором находится большинство растущих SaaS-компаний прямо сейчас. PaaS уже невозможен — экономически и архитектурно. IDP ещё недостижима — нет бюджета на платформенную команду, нет 50+ разработчиков, нет 6–12 месяцев на внедрение. Облако доступно технически, но работать в нём уверенно пока сложно.
И теперь я хотел бы вернуться к нашей этапности и обратить внимание как раз на переход с этапа 2 на этап 3. Здесь вскрывается новое противоречие: инфраструктура стала дешевле, но не стала проще. Всё, что раньше было скрыто за абстракцией платформы, — теперь ваша ответственность. И чтобы эту ответственность нести грамотно, нужна экспертиза.
Компания экономит на инфраструктуре, но увеличивает ФОТ: Медианная зарплата выделенного DevOps-инженера в России может быть сопоставима с экономией на инфраструктуре при переходе с PaaS. На горизонте года экономия может быть близка к нулю, зато появляются контроль и возможность масштабироваться дальше.
И вот парадокс 3-его этапа: облако дало контроль, но не дало уверенности. Команда технически может настроить что угодно, но не знает точно, правильно ли она это сделала.
Недостатки, которые проявляются на этом этапе:
- Terraform-репозиторий, который понимает один человек (и он вот именно сейчас в отпуске или приболел).
- K8s-кластер, настроенный по туториалу, который «работает, главное, рядом не дышать».
- Новый разработчик не может поднять окружение за день, а иногда — за неделю.
- Деплой есть, но стандартов деплоя нет — каждый сервис живёт по своим правилам.
- Observability настроена частично: метрики есть, но на инцидент реагируют постфактум.
Цена ошибки на этом этапе резко возрастает. Неправильно настроенный security group — это потенциальная утечка данных клиентов. Неверное автомасштабирование — это либо недоступность в пике, либо счет в ×5 или ×10 от ожидаемого. Отсутствие network policies в кластере — это отсутствие изоляции между тенантами на уровне инфраструктуры, даже если в коде всё правильно.
Кстати, обычно в этот момент звучат слова: «А что, сложно самим terraform-скриптик написать?» Нет, написать не сложно. Сложно:
- поддерживать его три года;
- онбордить новых разработчиков;
- стандартизировать окружения;
- не превратить инфраструктурный репозиторий в хаос модулей.
Terraform — это инструмент, а платформа — это процесс + стандарты + автоматизация + UX для разработчика.
Кажется, что между моментом, когда использование Vercel, Heroku становится экономически и архитектурно нерациональным, до момента создания (или покупки) IDP либо выделения штата DevOps-инженеров, есть озвученный нами разрыв, в рамках которого может быть решение, способное упростить разработку продуктов и проложить мостик в следующий этап.
И это не временный gap в пару месяцев. Это яма, в которой компании сидят годами, латая terraform-скрипты, теряя время разработчиков на инфраструктурные задачи и накапливая технический долг в самом чувствительном месте — в инфраструктуре, от которой зависит выполнение SLA перед клиентами.
Возможно, именно здесь формируется новая категория решений — инфраструктурный слой для растущих SaaS, которым рано строить собственную платформу, но поздно оставаться на чистом PaaS. Мы заметили, что переход начинают рассматривать при совпадении трех факторов:
- Инфраструктура начинает стоить как зарплата инженера.
- Клиенты требуют прозрачности и настроек безопасности.
- Архитектура продукта упирается в ограничения платформы.
Если посмотреть на рынок инструментов: решений для этапов 1 и 2 много — Replit, Vercel, Heroku, Railway, Dockerhost, Amvera; решений для этапа 4 тоже хватает — Backstage, Humanitec, Qovery, VK Dev Platform, «Сфера». А вот таких, которые позволят перейти с этапа 2 на этап 3, пока не существует. Нет инструмента, который одновременно:
- Дает реальный контроль над инфраструктурой (не абстракцию поверх неё).
- Не требует выделенной DevOps-команды для поддержки.
- Устанавливает разумные стандарты по умолчанию — сети, безопасность, деплой.
- Позволяет разработчикам действовать самостоятельно, не становясь инфраструктурными инженерами.
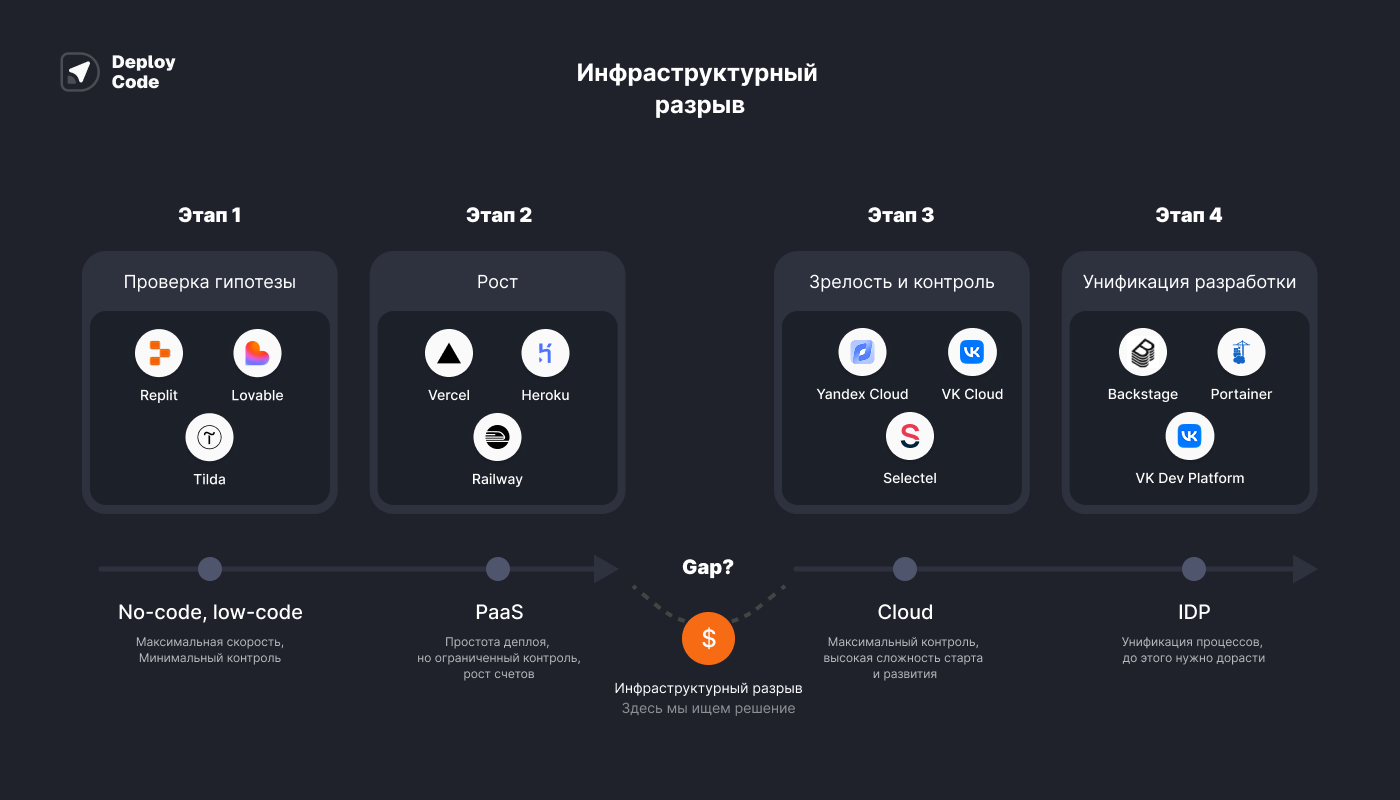
Непрямой путь от прототипа до зрелого продукта
Вывод
Итак, мы с вами разобрали развитие решения и сформировали модель зрелости. Путь от Replit до IDP — это не просто линейное движение со сменой используемых инструментов. Это новая парадигма на каждом этапе. Сначала скорость важнее контроля, потом контроль важнее удобства, затем управляемость важнее гибкости. Проблема в том, что переходы между этапами болезненны и часто запаздывают — компании эксплуатируют инструмент дольше, чем нужно, потому что стоимость выхода всегда выше, чем кажется на входе.
Именно в этот момент — между этапами 2 и 3 — возникает главный парадокс роста большинства разрабатываемых решений. Пока команда находится на PaaS-платформах, она получает отличный DevEx (ведь большинство сложностей спрятаны под абстракциями): быстрые деплои, минимальные настройки инфраструктуры и околонулевые накладные расходы. Но по мере роста продукта открывается обратная сторона: появляются ограничения сетевой модели, сложности с безопасностью, растут требования корпоративных клиентов и непредсказуемость инфраструктурных расходов.
Переход напрямую в облако решает часть этих проблем — появляется полный контроль над сетью, инфраструктурой и безопасностью. Но вместе с этим команда сталкивается с другой крайностью — сложностью настройки, ростом DevOps-нагрузки и необходимостью самостоятельно выстраивать процессы, которые раньше брала на себя платформа.
В таблице ниже — обобщённые диапазоны для каждого этапа; конкретные цифры нашего примера с документооборотом находятся ближе к нижней границе на старте каждого этапа.
[ Таблица ]
Промежуточный этап между миром PaaS и полным переходом в облако и стал отправной точкой для создания DeployCode — платформы, которая позволяет напрямую работать в облаке, но без инфраструктурного хаоса. Наше решение сохраняет удобство деплоя и автоматизации, характерное для PaaS, но при этом даёт команде контроль над инфраструктурой, сетями и безопасностью, необходимый для растущих SaaS-продуктов.
В следующих статьях мы разберём, из чего состоят и как работают упомянутые платформы Vercel и Heroku (мы намеренно вынесли за скобки, что такое dyno в Heroku и serverless runtime в Vercel), а также расскажем, как особенности этих решений повлияли на создание DeployCode.
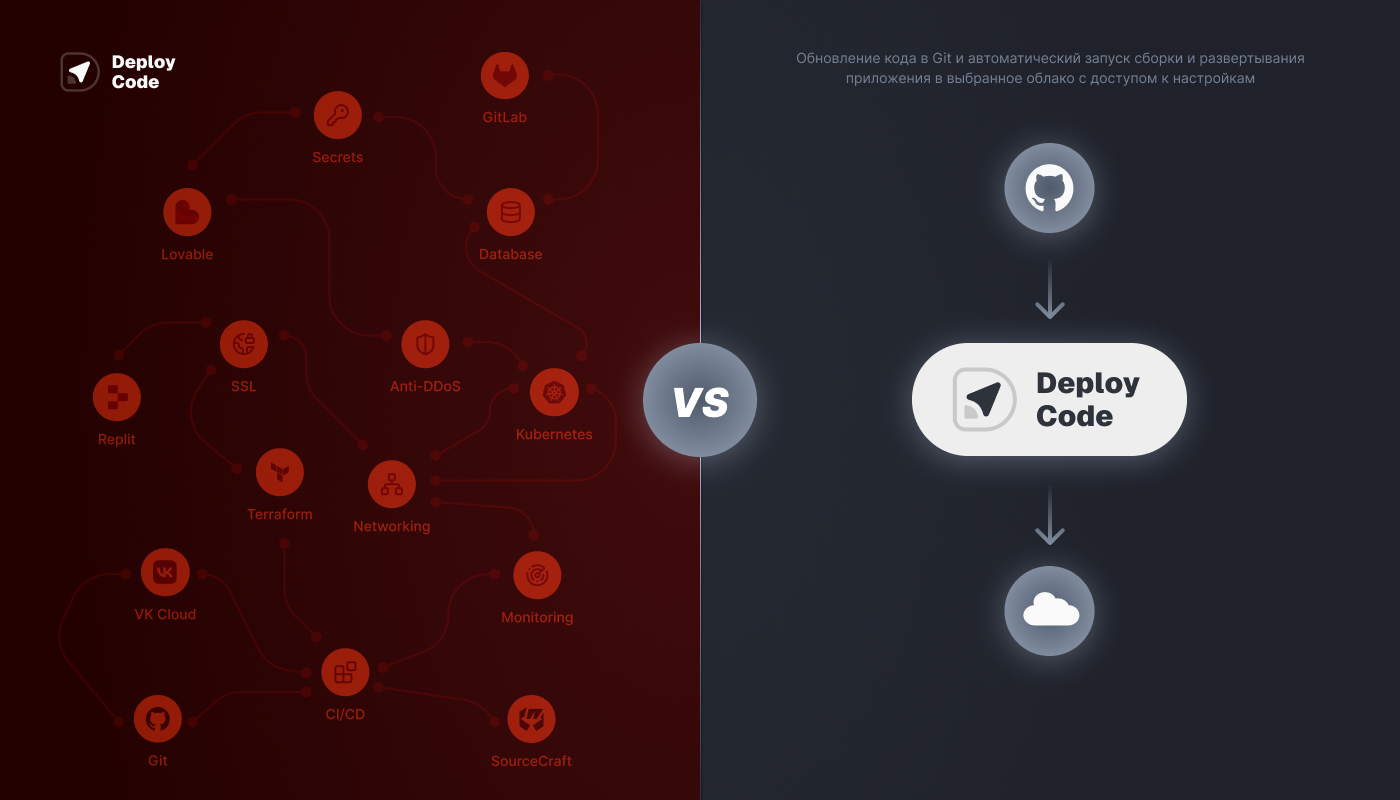
То, что хочется настраивать vs. то, что хочется использовать